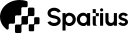
将实时 AI 数字人接入 RAG 时,最稳妥的方式不是把检索交给数字人供应商,而是保持现有 RAG 与 Agent 边界:应用负责身份、权限、检索、引用、工具、记忆和回复审批,数字人只呈现已经允许说出的语音。
核心结论
- 检索与权限应留在应用层,而不是隐藏在数字人层。
- 在 TTS 前定义回复契约,区分可说文本、屏幕引用和工具状态。
- 不要因为流式输出更快,就在证据尚未稳定时过早朗读。
- 使用固定测试集分别验证检索正确性与数字人呈现质量。
把检索保留在数字人层之外
典型链路是:用户输入进入应用,应用根据身份和权限执行检索或工具调用,Agent 生成可验证回复,TTS 产生数字人要说的音频,然后才进入动作与渲染层。RAG 的基本思路可参考原始论文 Retrieval-Augmented Generation。
这个边界便于更换向量库、重排器、LLM、TTS 或数字人供应商,也能让权限判断发生在内容被检索和朗读之前。
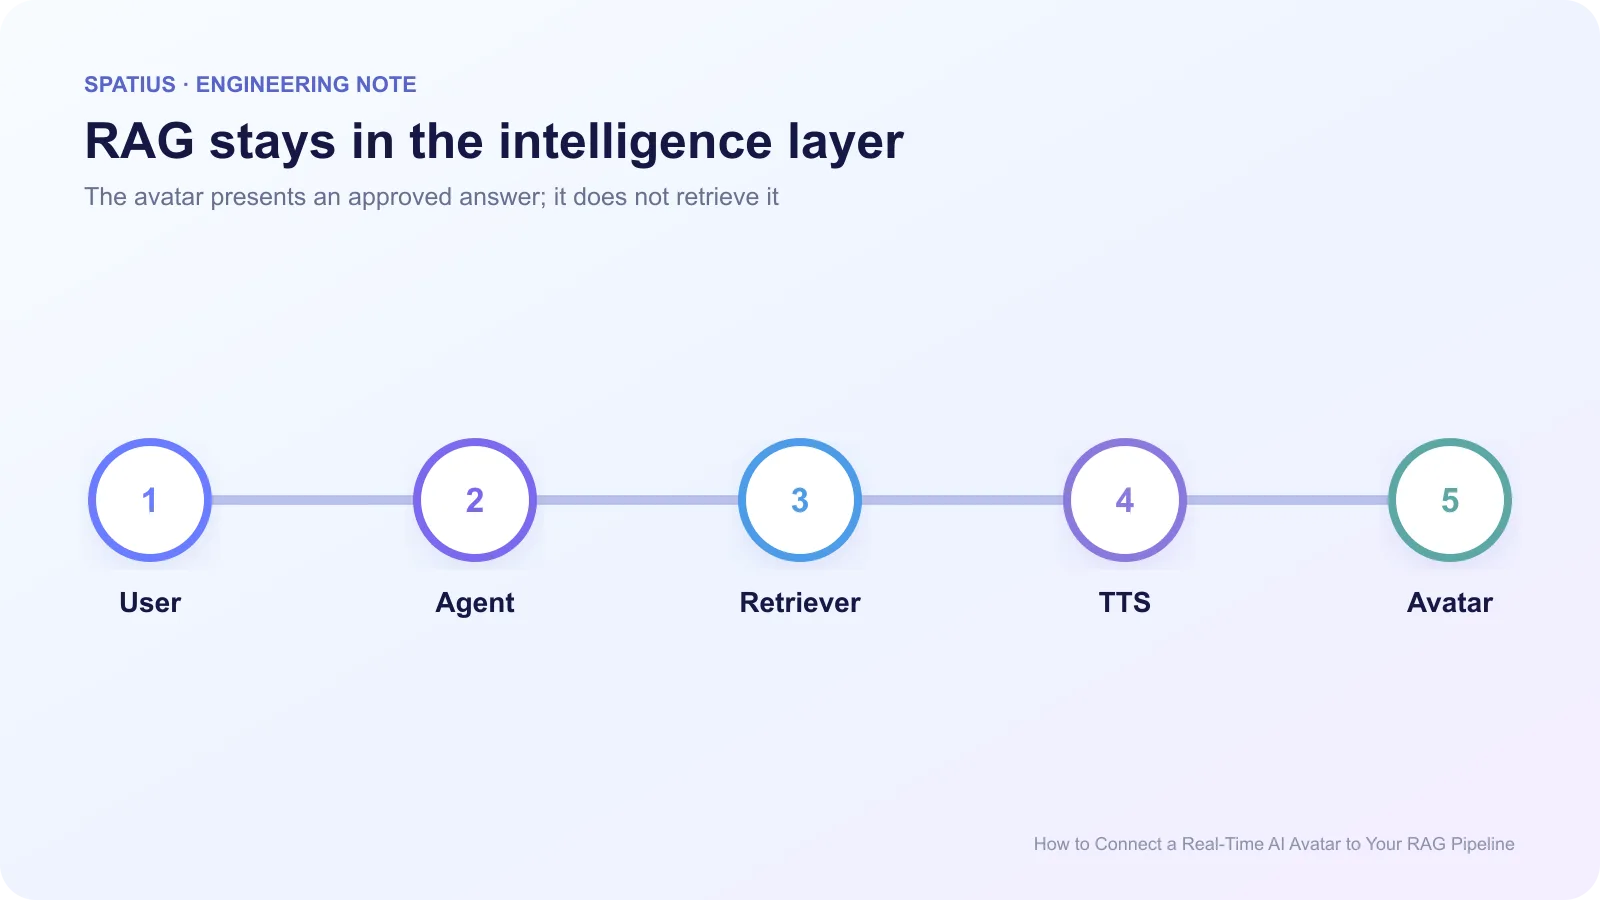
在加入语音前定义回复契约
回复对象最好至少包含:可以朗读的答案、结构化引用、使用过的工具、置信或安全状态,以及无法回答时的回退。引用通常更适合显示在界面上,而不是逐字朗读;语音可以说“我找到了两份相关文档”,同时屏幕展示标题、片段和链接。
OpenAI 的 RAG 评估说明强调要分别检查检索与回答。对数字人体验,还要增加语音可理解性、首段时机和引用可见性等指标。
在检索和朗读前应用权限
权限过滤应尽量进入查询过程,而不是先取回大量内容再在最后删除。应用需要决定用户可访问哪些数据源、哪些工具可运行、哪些字段不能进入 Prompt 或日志。可以参考 OWASP LLM Top 10中的提示注入、敏感信息泄露和过度授权风险。
会话记忆也应该属于应用或 Agent。它需要与用户、租户、保留策略和删除流程保持一致,而不应依赖数字人会话是否还在连接。
流式输出不要说得太早
如果每个 LLM Token 立即进入 TTS,数字人可能在检索尚未完成、引用尚未确定或工具结果尚未返回时开始说话。更稳妥的方式是使用句子边界、确定性较高的短段落或应用定义的提交点。
对低风险解释可以更早开始;涉及账户数据、建议、金额或工具结果时,应等待应用确认。界面可以先显示“正在查找相关资料”,而不是让数字人用未经确认的内容填满等待时间。
把批准后的音频连接到 Spatius
Spatius 不替代 RAG。应用把经过批准的回复交给 TTS,得到数字人语音音频;Motion Server 将音频转换为动作数据,AvatarKit 在客户端本地渲染。Spatius 文档总览描述了这个边界。
如果你已有 Agent,可先参考为现有 SaaS Agent 添加数字人,从一个工作流验证,而不是一次迁移全部对话。
常见问题
数字人应该朗读引用吗?
通常不需要逐字朗读 URL。语音说明答案依据,界面展示可点击来源,会更清楚也更容易核验。
可以先不接数字人测试 RAG 吗?
可以,而且应该先这样做。先验证检索、权限与回答契约,再单独验证 TTS、动作和渲染。