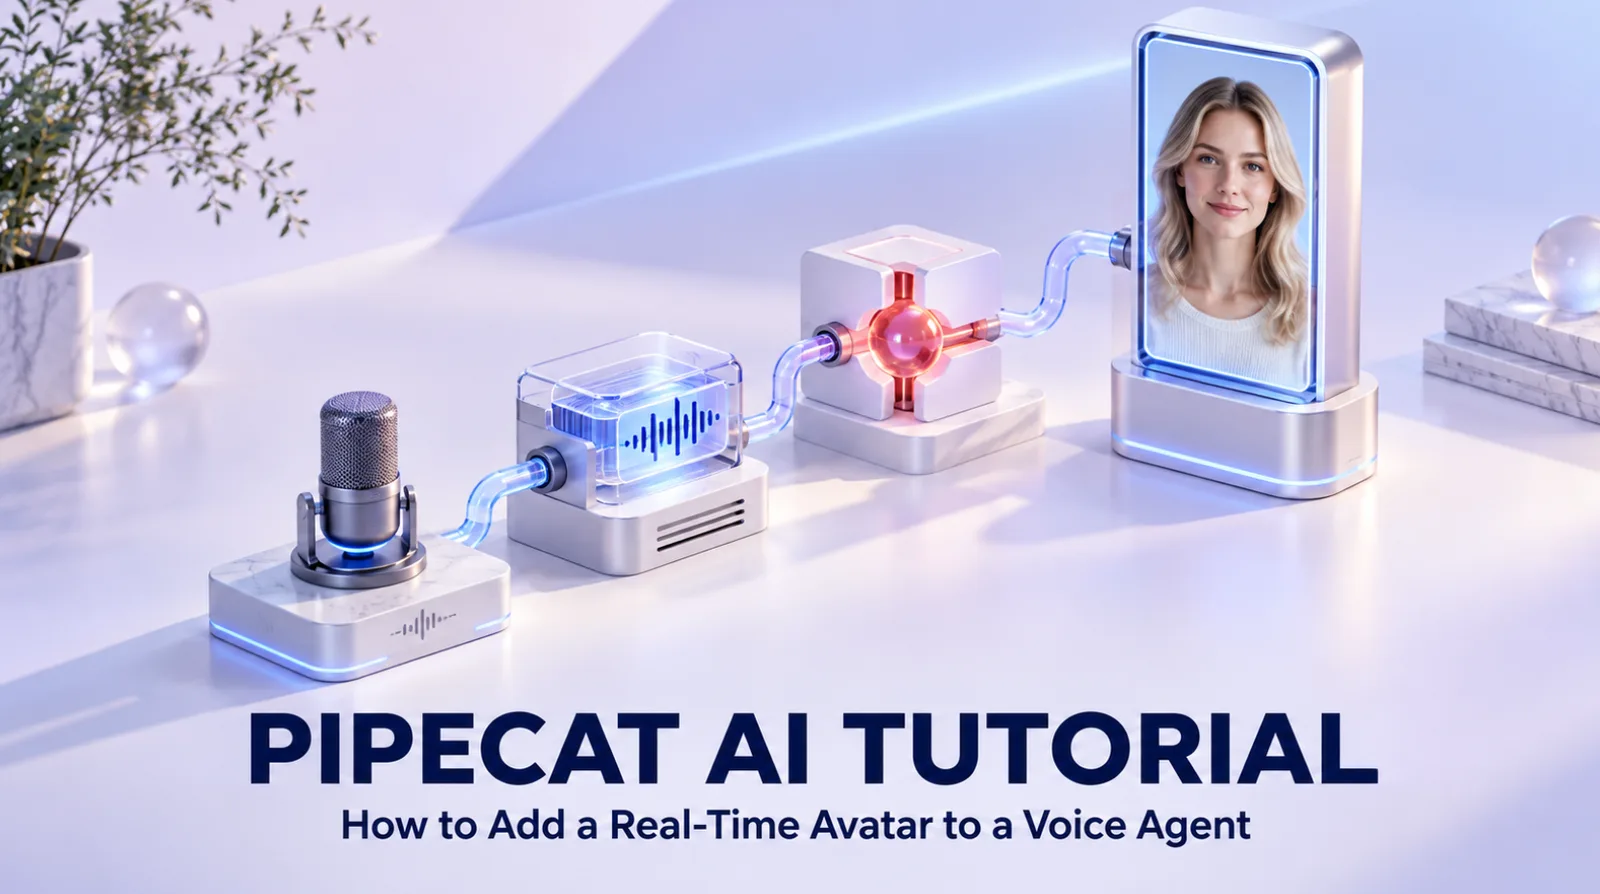
Pipecat 语音智能体可以增加实时虚拟人,而不必把 STT、LLM、TTS、工具或对话逻辑迁移到另一个平台。 Pipecat 继续控制智能体管线,只把最终确认的机器人语音分支交给 Spatius,再由 AvatarKit 在本地渲染对应的虚拟人动作。
独立教程声明: Spatius 与 Pipecat 或 Daily 不存在隶属、背书或官方集成合作关系。本文基于公开文档说明一种参考架构,不代表已经提供封装好的 Pipecat 插件。
最后核验:2026 年 9 月 22 日。
Spatius 位于 Pipecat 管线的什么位置
Pipecat 是用于实时语音和多模态智能体的开源 Python 框架。它的管线负责协调传输层,以及语音识别、语言模型、工具和文本转语音等服务。
Spatius 从机器人语音已经确认并完成合成之后开始工作。其架构文档说明:Motion Server 接收虚拟人语音,返回动作数据,AvatarKit 再在客户端本地完成渲染。
| 管线职责 | Pipecat 应用 | Spatius |
|---|---|---|
| 用户媒体与传输 | 通过所选 transport 负责 | 不负责 |
| STT、LLM、工具、记忆和对话流程 | 负责 | 不负责 |
| TTS 服务与机器人语音 | 负责 | 接收最终语音 |
| 面部动作生成 | 无需负责 | Motion Server 负责 |
| 虚拟人渲染 | 产品客户端或其他选定渲染器 | AvatarKit 本地渲染 |
| 产品 UI、策略、分析与人工接管 | 负责 | 不负责 |
因此,集成问题不是“如何替换 Pipecat”,而是“在哪里可以把机器人输出音频交给虚拟人层,同时不破坏现有管线”。
参考架构
Pipecat 的管线与帧处理模型让不同类型的 frame 依次经过 processors。典型语音智能体路径如下:
用户音频
  ↓
Pipecat transport 输入
  ↓
STT → LLM/工具 → TTS
                    ├─ 给用户播放的机器人音频
                    └─ 给 Spatius 的已确认机器人音频
                                  ↓
                         Motion Server
                                  ↓ 动作数据
                         AvatarKit 客户端渲染
只有机器人输出音频应该驱动虚拟人。用户麦克风 frame、转录、工具参数和私有应用上下文应留在原本负责它们的管线中。
选择客户端音频路径还是后端音频路径
Spatius 提供 Direct Mode 和 Backend Mode,Pipecat 则支持多种客户端和服务器传输方式。选择时应看音频归属,而不是看哪一个演示代码最短。
| Pipecat 架构 | Spatius 路径 | 最适合的情况 |
|---|---|---|
| Pipecat 客户端接收机器人音频,并能把它暴露给应用 | Direct Mode | 客户端应发送虚拟人语音并本地渲染 |
| Pipecat 服务器持有 TTS 音频 frame | Backend Mode | 后端应向 Spatius 提供音频并控制下游传递 |
| Pipecat 实际使用的是 LiveKit Agents | 已有 Spatius LiveKit 集成 | 现成 LiveKit 路径与真实智能体框架一致 |
Pipecat 的传输选择文档强调客户端与服务器 transport 必须匹配。增加虚拟人不会取消这项约束。Daily、SmallWebRTC 或其他支持的 transport 仍负责 Pipecat 会话,Spatius 保持为独立视觉层。
路径 A:客户端音频接入 Spatius Direct Mode
当产品客户端已经收到机器人输出音频时,可以使用 Direct Mode。客户端从自有后端取得短期 Spatius Session Token,初始化 AvatarKit,加载虚拟人,连接 Motion Server,并按照当前 Direct Mode 客户端文档提供机器人语音。
产品必须避免两条播放路径产生回声。应该定义唯一的机器人音频输出,让虚拟人分支只负责生成同步动作。
收到 Pipecat 机器人音频时:
  保持音频顺序
  把已确认语音发送给用户播放路径
  把对应虚拟人语音发送给 Direct Mode

机器人语音结束时:
  完成当前虚拟人轮次

用户中断时:
  停止机器人播放
  停止或清除虚拟人轮次
以上是伪代码,并不表示存在官方 Pipecat adapter。具体方法名应以当前 Pipecat 客户端事件和 AvatarKit SDK 参考文档为准。
路径 B:服务器 frame 接入 Spatius Backend Mode
当 Pipecat 服务器持有 TTS 输出 frame 时,可以使用 Backend Mode。Pipecat 文档说明了如何构建自定义 FrameProcessor,以便在管线中观察或转换特定 frame。生产架构可以使用职责明确的 processor 或侧分支,把经过确认的机器人语音交给 Spatius Server SDK,同时继续向下游传递原始 frame。
这个 processor 不应变成第二套对话引擎,它只负责虚拟人交接,并保留:
- frame 顺序;
- 音频格式和采样率要求;
- 回答边界;
- 取消和中断信号;
- 背压与错误报告。
Backend Mode 给应用更高控制力,也带来更多责任。后端必须通过团队运营的 transport,把最终音频和动作负载传递给 AvatarKit 客户端。
中断处理是最难的部分
Pipecat 的中断文档说明了用户说话时如何停止进行中的机器人输出。虚拟人必须遵循同一个取消边界。
如果 Pipecat 已经取消 TTS,而视觉层仍继续消费缓冲语音,虚拟人会显得无视用户。如果虚拟人停止但音频继续,口型同步就会中断。应该把中断视为一个产品事件,并协调两个消费者同时响应。
至少需要测试:
- 第一帧机器人音频出现前发生中断;
- 连续语音期间发生中断;
- 工具调用等待期间发生中断;
- TTS 连接失败;
- Pipecat 正常但 Spatius 连接失败;
- 任一层失败后的重连和清理。
Pipecat 的 service events和 Spatius 客户端/服务器错误信息应进入同一套会话可观测系统,同时保留实际失败层级。
成本和性能必须分层测量
Pipecat 本身是开源框架,但已部署智能体仍可能产生 transport、托管、STT、LLM、TTS 和可观测成本。Spatius 会增加独立的虚拟人用量成本。完整平台因为负责更多层级,可能给出一个统一价格;模块化的 Pipecat 与 Spatius 系统也应保留模块化成本模型。
| 指标 | Pipecat/智能体层 | Spatius/虚拟人层 |
|---|---|---|
| 语音识别延迟 | 在此测量 | 不适用 |
| LLM 与工具延迟 | 在此测量 | 不适用 |
| 首段 TTS 音频时间 | 在此测量 | 输入边界 |
| 音频到动作传递 | 不适用 | 在此测量 |
| 客户端渲染稳定性 | 产品客户端 | 在目标设备测量 AvatarKit |
| 用量成本 | 托管与所选 AI 服务 | Spatius 价格与虚拟人用量 |
不要把单一端到端延迟当作虚拟人 benchmark。应保留每个测量点,才能把性能回退归因到正确服务。
Pipecat 与 Spatius 组合适合什么团队
这种架构适合因为供应商、transport、工具和对话流程控制力而选择 Pipecat,并且现在希望增加拟真面孔、但不想替换现有成果的团队。虚拟人仍是一个组件,而不是新的智能体平台。
如果买方希望一家供应商提供完整对话栈并流式传输最终虚拟人视频,它就不一定适合。完整平台可能减少自定义工程,但也会改变供应商灵活性、渲染归属和成本结构。
如需继续评估,可阅读 BYO LLM 与 TTS 虚拟人 API 指南和端侧与云端虚拟人架构对比。
Pipecat 虚拟人常见问题
Spatius 有官方 Pipecat 插件吗?
本文不声称存在官方插件。文章说明的是一种第三方音频交接架构,使用 Pipecat 已公开的管线模型以及 Spatius Direct Mode 或 Backend Mode。
Spatius 会替代 Pipecat 的 TTS 服务吗?
不会。Pipecat 保留所选 TTS 服务并生成机器人语音。Spatius 使用这段音频生成虚拟人动作,并在客户端本地渲染虚拟人。
Pipecat 集成应该使用 Direct Mode 还是 Backend Mode?
客户端持有机器人音频并能把它交给 AvatarKit 时使用 Direct Mode。Pipecat 服务器持有音频 frame,而且团队能够运营下游传递时使用 Backend Mode。
虚拟人可以使用与用户播放不同的音频流吗?
虚拟人应使用相同的机器人语音内容和时间关系。独立合成或重新排序分片会造成可见的口型同步和中断问题。
上线前必须测试什么?
应测试音频格式、frame 顺序、轮次结束、插话、TTS 故障、Spatius 故障、重连、目标设备渲染,以及分层成本与延迟。
保留语音智能体,增加视觉层
Pipecat 可以继续负责对话管线,Spatius 则负责虚拟人动作和本地渲染。这样的组合系统可以在不重建智能体的情况下增加一张脸。
带上你的 Pipecat 管线、transport 和目标客户端,我们可以帮助你在不重建语音智能体的前提下评估 Direct Mode 或 Backend Mode。 预约演示, or ,或查看 Spatius 价格.。