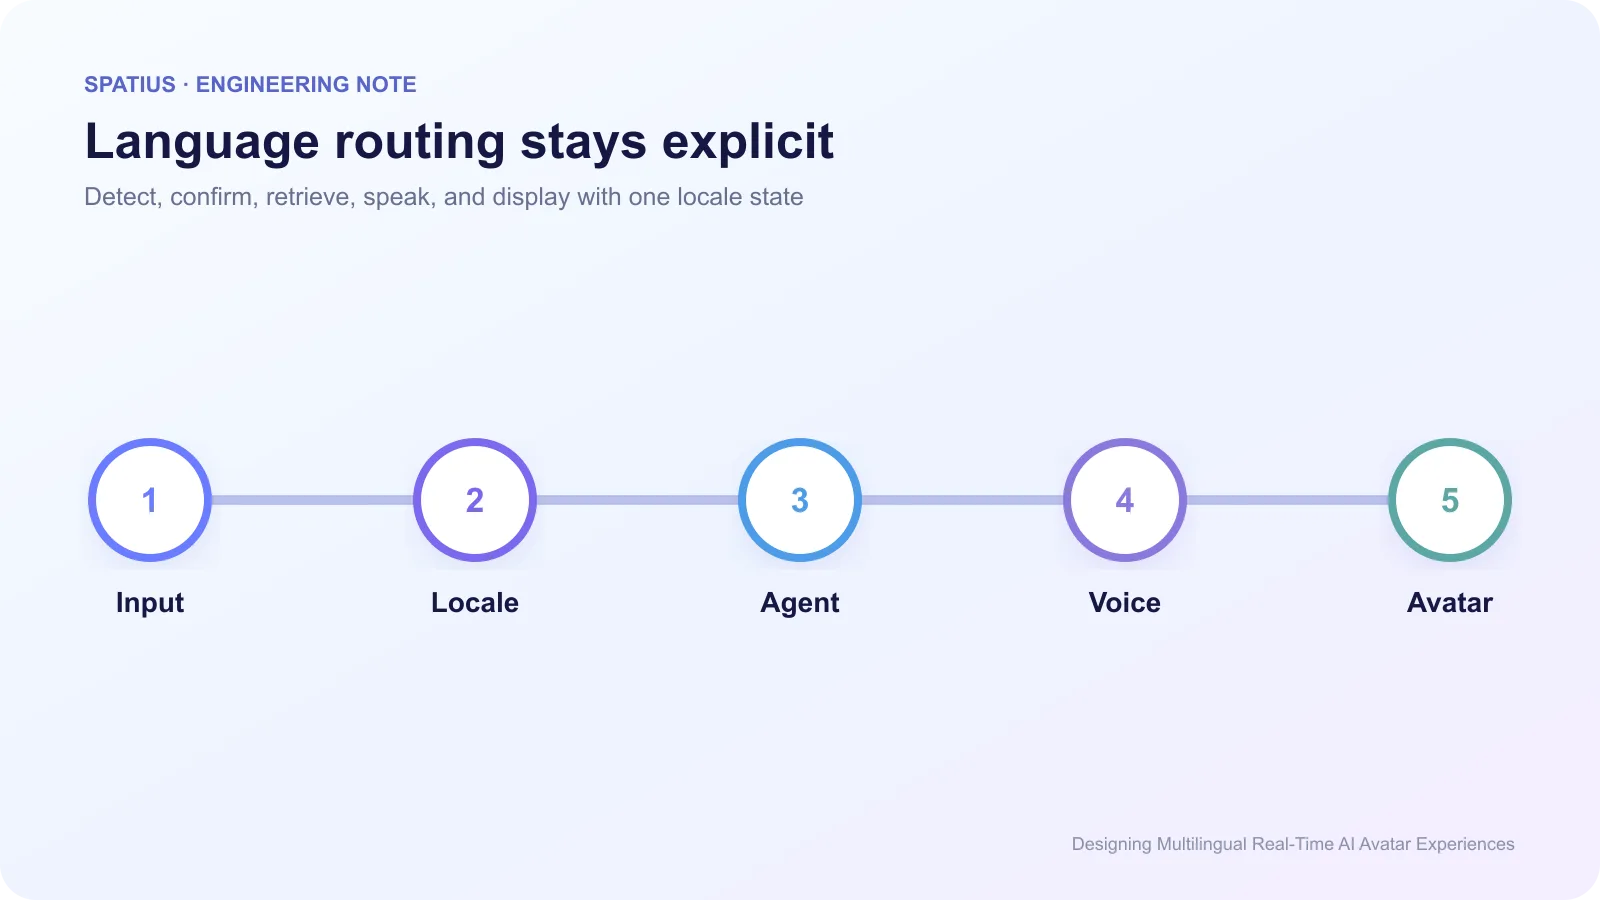
多语言 AI 数字人不是在回答末尾增加翻译。语言状态必须贯穿麦克风输入、ASR、检索、Agent、TTS、字幕、日期数字格式、界面和回退路径,否则用户会遇到“听懂了英语,却用错误语言检索和发音”的混合体验。
核心结论
- 使用一个由应用拥有的 locale 状态驱动整条回答链路。
- 对每种语言分别验证识别、检索、生成、发音、字幕和打断。
- 保持声音与人物身份一致,不要只追求语言数量。
- 从一个业务价值高、测试资源足够的语言组合开始。
使用统一的应用语言状态
语言可以来自用户设置、账户区域、明确选择或受控的自动检测。不要让 ASR、LLM、TTS 和字幕各自猜测语言。应用应记录当前 locale、允许的切换方式,以及何时需要用户确认。
W3C Internationalization提供了语言标签、文本方向和区域格式等基础参考。语言状态还应区分“界面语言”“用户输入语言”和“期望回复语言”。
路由完整回答链路
一旦语言确定,应用需要选择对应的 ASR、检索语料、Prompt、工具参数、TTS 声音与字幕规则。只翻译最终文本可能造成检索证据来自错误语言,或工具把日期、货币与姓名解析错。
跨语言检索还要决定:查询翻译后检索同一知识库,还是直接检索本地化内容。无论选择哪一种,都应在引用中保留真实来源语言与版本。
保持声音身份一致
同一个数字人在不同语言中应尽量保持可识别的声音性格、语速、正式程度和品牌语气。若某种语言只能使用完全不同的声音,应在用户切换时明确变化,不要假装是同一个自然连续的说话者。
专有名词、产品名和人名需要发音词典或 SSML 规则。参考 W3C SSML处理读音、停顿与语速,但要在实际 TTS 引擎中验证支持情况。
把字幕与语音一起设计
字幕不是事后补充。它需要与正在播放的语音对应,并支持换行、阅读速度、文本方向和字体覆盖。用户还应能切换到纯文本路径。Web 端可以参考 WCAG的可感知与可操作要求。
端到端测试语言质量
为每种语言准备真实任务集,覆盖短问答、长数字、姓名、日期、行业术语、用户打断、静默和错误恢复。母语评审应同时检查内容是否正确、口语是否自然、字幕是否匹配,以及工具是否使用正确区域格式。
自动指标可以帮助发现回归,但不能替代母语用户对语义、礼貌程度与文化语境的检查。
保持数字人边界清晰
应用拥有 locale、ASR、LLM、检索、TTS、字幕与策略;Spatius 把最终数字人语音音频转换为动作数据,AvatarKit 本地渲染。Spatius 集成指南描述了可选路径,但不会替代应用的多语言路由。
常见问题
数字人应该自动切换语言吗?
低风险场景可在高置信度时建议切换,但涉及重要信息时应由用户确认,并提供固定语言设置。
每种语言都需要不同数字人吗?
不一定。关键是声音、发音、字幕与身份是否一致;是否使用不同形象属于产品与品牌决定。