
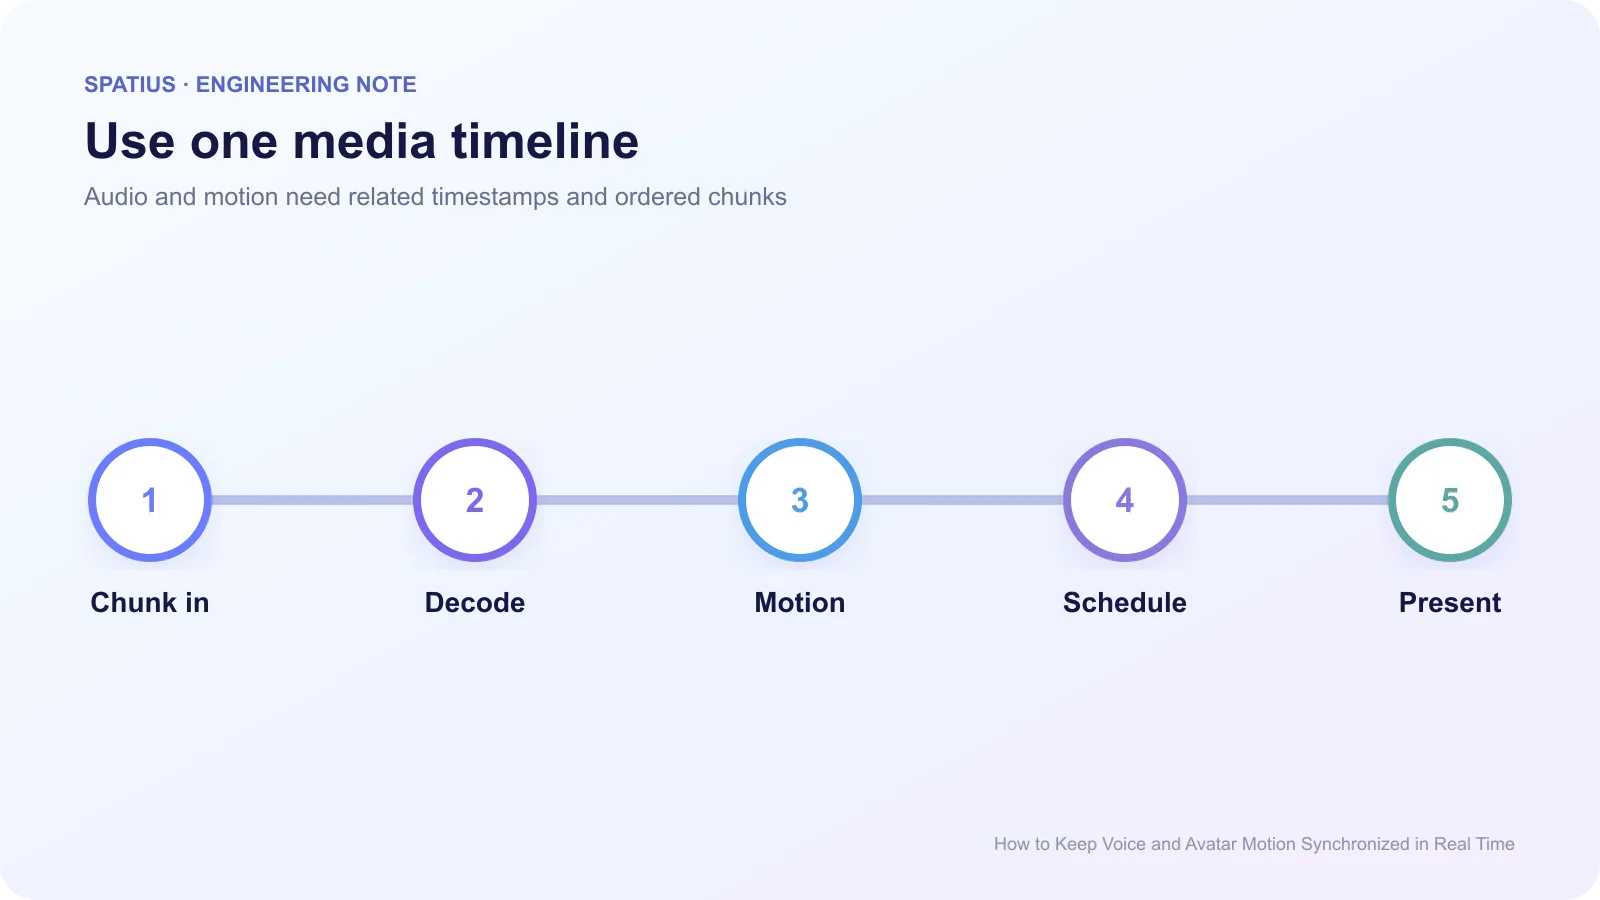
语音与数字人动作同步,不能依赖“两个流差不多同时到达”。系统需要一个共享媒体时间线,知道每段音频、动作分片、播放器位置和渲染帧对应同一个回复中的什么时刻。
核心结论
- 使用一个媒体时钟或可靠时间戳对齐音频与动作。
- 分别测量起始偏移和长回答中的累计漂移。
- 先判断是固定偏移、持续漂移、抖动还是重连错位。
- 只在句子或其他安全边界重同步,避免突然跳口型。
使用统一媒体时间线
墙上时钟不足以同步两个独立播放器。音频和动作应共享会话、轮次、序号与相对时间戳。客户端根据实际音频播放头选择对应动作,而不是只按消息到达顺序播放。
Web 端可以参考 Web Audio API的高精度音频时钟与调度能力,并记录渲染循环相对于播放头的位置。
分开测量起始偏移与漂移
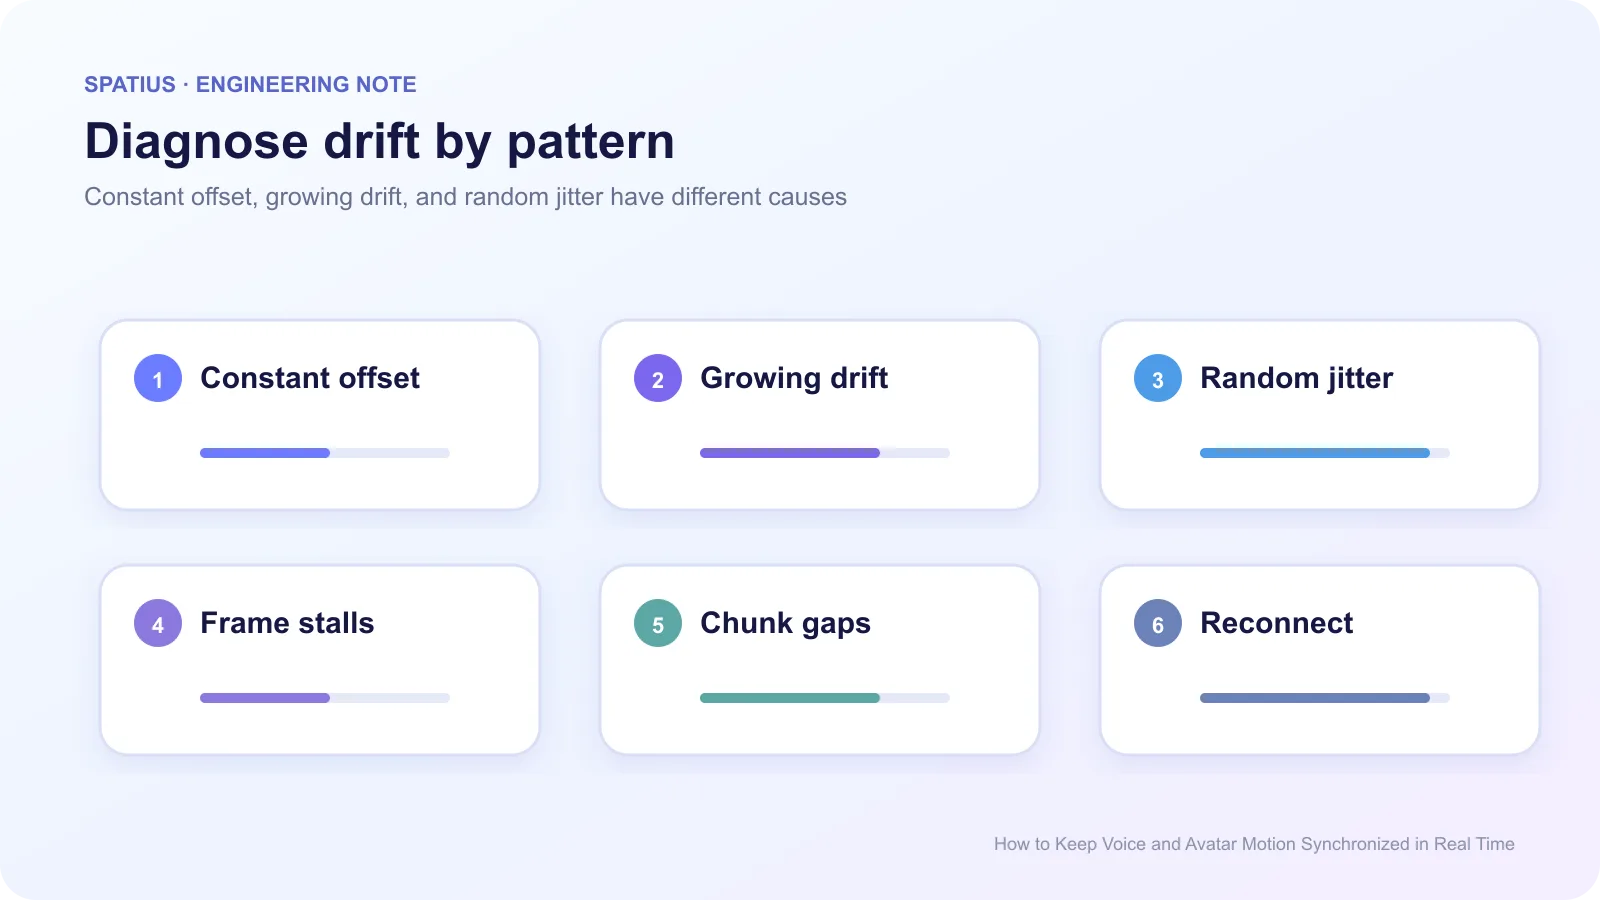
起始偏移表示第一段声音与第一段相关动作开始的差值;漂移表示长回答中差值是否持续扩大。固定偏移可能来自缓冲或启动顺序,累计漂移则更可能来自时钟、采样、丢帧或独立调度。
不要只让测试人员回答“看起来同步”。建立带时间码的标准音频与动作样本,分别记录中位数、p95 和长回答末尾偏移。
分类同步故障
- 固定迟到: 每次动作都比音频晚相近时间;
- 逐渐漂移: 开始正常,越说越不同步;
- 突发跳动: 网络抖动或缓冲耗尽后突然错位;
- 重连错位: 新连接从错误轮次或错误播放位置继续。
RTC 路径可结合 WebRTC getStats观察抖动和丢包;WebSocket 路径则记录分片序号、到达时间与播放时间。
谨慎处理分片边界
TTS 分片太小会增加调度开销和边界不稳定,太大则增加首段等待。每个分片都应保持顺序、轮次与时间信息;丢失、重复或晚到时,客户端要有明确策略。
在安全时刻重同步
不要在用户正在观察的词中间突然跳到新动作。可以在句尾、停顿或新轮次开始时重新锚定。若漂移超过可接受范围,短暂切到纯音频也比持续错误口型更可靠。
Spatius 中的同步边界
应用和 TTS 产生数字人语音音频,Motion Server 将音频转为动作数据,AvatarKit 在客户端本地渲染。应用仍应保留轮次与播放状态,并按所选集成路径记录音频发送、动作接收和本地播放时刻。
启动同步问题也可结合如何缩短首个动作时间排查。
常见问题
固定延迟能修复口型同步吗?
只能修正稳定的固定偏移,无法解决累计漂移、丢帧、重连或错误分片顺序。
动作迟到时是否应暂停音频?
取决于产品场景和延迟程度。短暂缓冲可能可接受;持续停顿通常更差。应设置阈值,并准备纯音频或文本回退。