
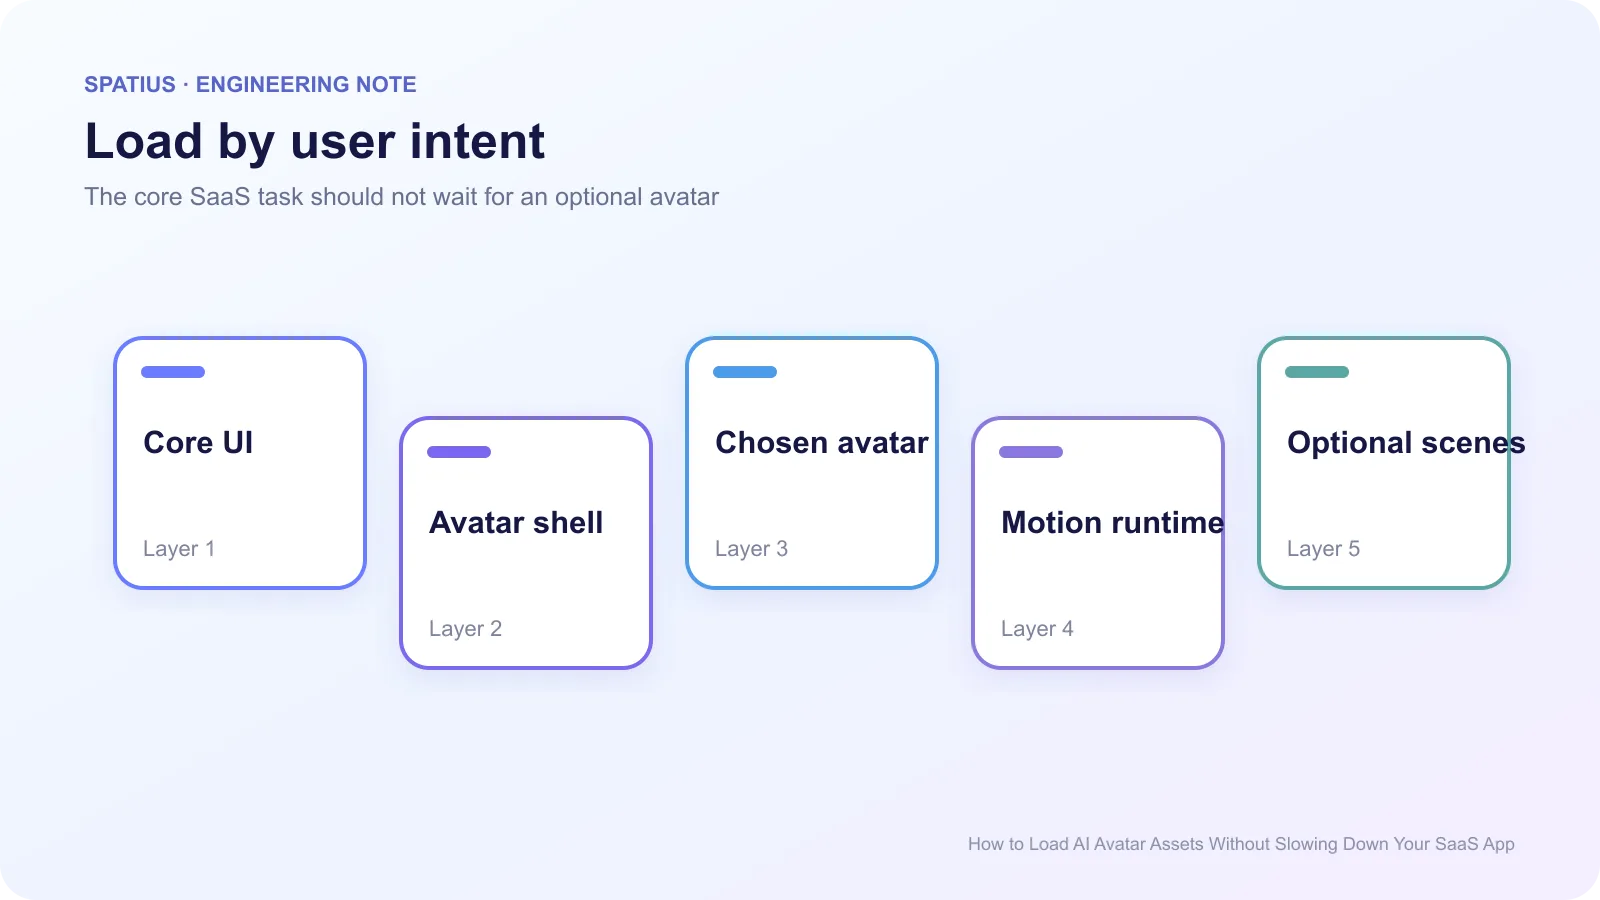
正确的加载顺序是先让核心产品可用,再根据明确的用户意图准备 Avatar。大体积资源应分层加载、使用不可变版本 URL、分别测量下载与解码,并在真正可互动前显示清晰的 Ready 状态。不要为了可能不会发生的会话,预加载全部模型和纹理。
1. 先定义产品性能预算
Avatar 不应让登录、控制台或主要工作流变慢。先记录没有 Avatar 时的 Core Web Vitals,再为 Avatar 增量设置预算:额外下载量、主线程长任务、显存占用、首次可互动时间和失败时的恢复成本。
把资源分成三层:核心产品、会话准备、完整 Avatar。核心产品应优先;会话准备可在用户打开相关面板或接近入口时开始;几何、纹理和动画资源只有在确实需要时再加载。MDN Lazy Loading介绍了延迟非关键资源的基本原则。
2. 谨慎使用 preload 和优先级
preload只适合当前页面确定会用到的关键资源。把多个大模型都设为 preload,会与字体、脚本和首屏数据竞争网络。对重要但非阻塞资源,可以评估 Fetch Priority,并用真实瀑布图确认效果。
不要仅依据文件下载完成显示 Ready。几何可能仍在解压,纹理仍在上传 GPU,着色器仍在编译。应分别记录请求开始、下载完成、解码完成、GPU 准备和首个稳定动作。
3. 压缩适合压缩的内容
3D 几何可评估 Draco,纹理可评估 KTX 2.0。压缩能降低传输量,但可能增加设备端解码时间,因此必须在目标低端设备上测试,不能只比较文件大小。
浏览器的 Resource Timing API可以区分排队、连接和传输阶段。把它与自定义的解码、上传和首帧标记结合,才能知道“加载慢”到底发生在哪里。
4. 使用不可变缓存和版本清单
对已发布且不会修改的二进制资源使用内容哈希 URL,并配置长期缓存。新版本生成新 URL,不要覆盖旧文件。MDN HTTP 缓存指南说明了验证缓存和不可变资源的差异。
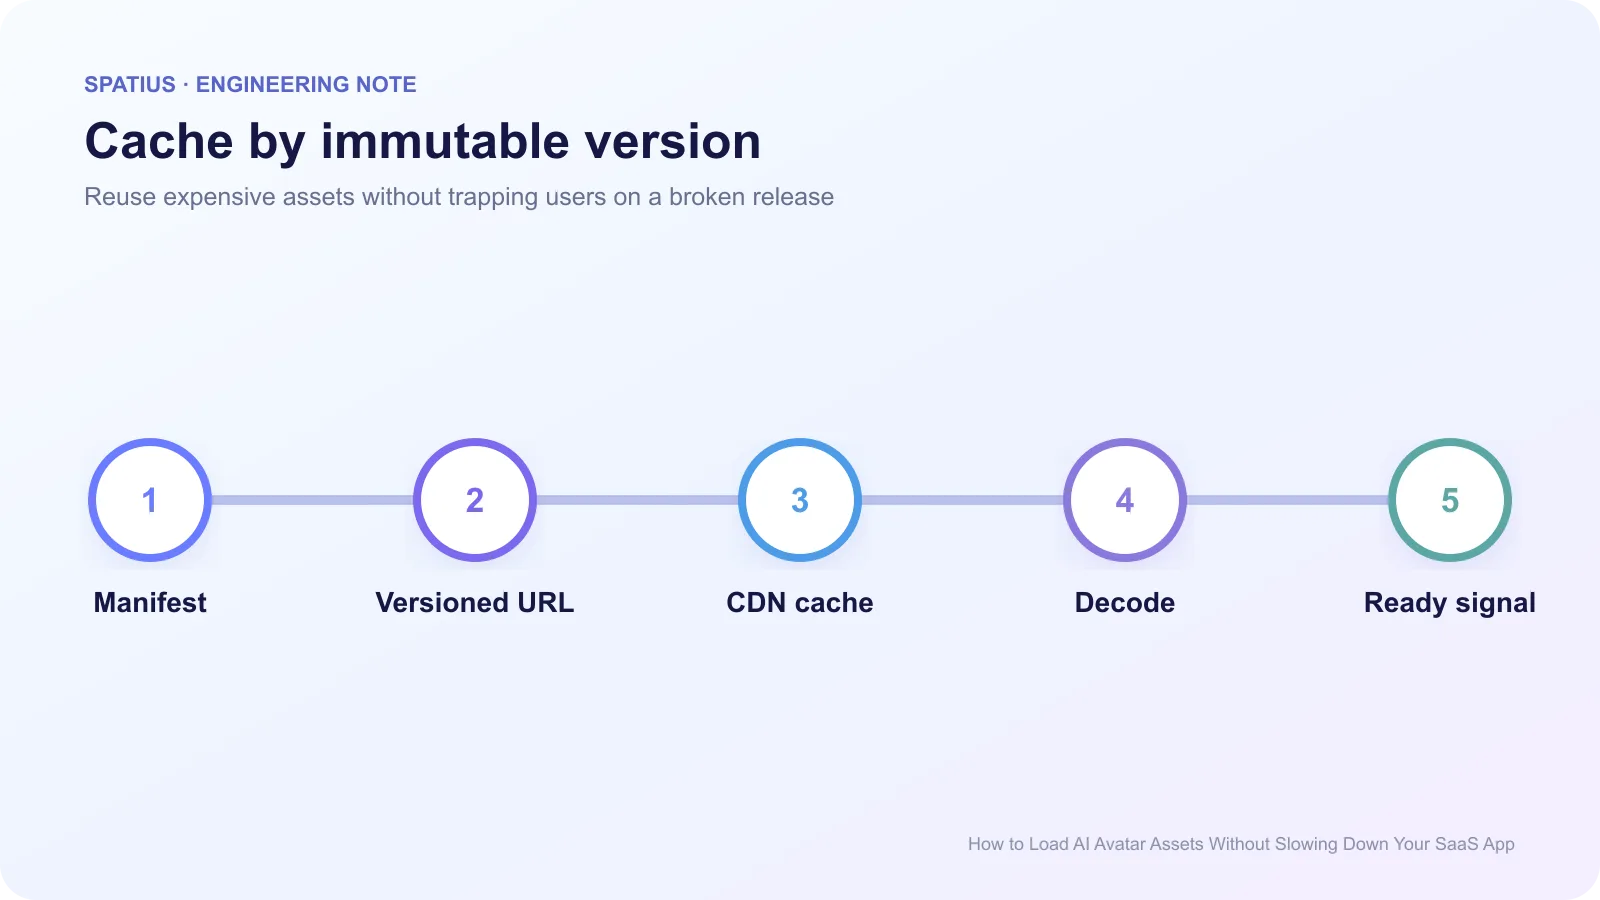
用一个小型版本清单记录 Avatar、几何、纹理、动作合同和 SDK 的兼容组合。发布新版本时先更新资源,再切换清单;回滚时只需恢复上一个已验证清单。若使用 CacheStorage,应明确清理策略,避免旧资源无限堆积。
5. 为失败保留可用路径
资源失败时,核心 SaaS 功能仍应可操作。可以提供重试、纯音频、文字或不启用 Avatar 的路径。监听 WebGL context lost,避免画布黑屏后仍显示“已连接”。
实施时可结合缩短首个动作时间的指南和低端设备测试方法,把资源策略与真实设备结果放在同一份发布检查表中。